AdversityBench: Evaluation & Ablations
Constrained POMDP formulation, 6 crisis domains, and 8 causal experiment records.
📌 Preliminary Note: This document is a preliminary exploratory note for the AI4I project. Full evaluation datasets, formal proofs, and replication code will be released soon.
Decision Framework: Modeling Adversity as a Constrained POMDP
In adversity assistance, interaction constitutes a partially observable sequence with hidden state transitions:
$$e = (s_0, o_0, h_0, a_0, s_1, o_1, h_1, a_1, \dots, s_T)$$
True state \(s_t\) contains the user's hidden resource and constraint vector. The explicit utterance \(o_t = \Omega(s_t)\) represents only partial information. The system's objective is to explore feasible actions without invasive overreach.
Six Crisis Domains Across 102 Standardized Scenarios
- 🏠 Housing & Eviction: Court hearing deadlines, lack of income proof, and transit inaccessibility.
- 🛡️ Physical Safety & Crisis: Monitored shared devices, confiscation of identification, and secure shelter access.
- 🏥 Medical Debt & Care: Insurance denial, prescription continuity periods, and hospital charity care qualifications.
- ⚖️ Legal Status & Deadlines: Visa expiration, legal status transitions, and legal aid intake queues.
- 💳 Predatory Debt & Finance: Coercive debt collection, bank account freezes, and structured debt relief.
- 👨👩👧 Elder & Child Caregiving: Caregiver burnout, custodial disputes, and respite care voucher queues.
Summary of Findings Across 8 Causal & Ablation Experiments
- Exp 1 (Option Collapse, n=102): Option capacity dropped by 46.9% to 67.9% across 7 frontier models under single-option instructions (\(p < 10^{-15}\)).
- Exp 2 (2×2 Factorial Ablation): Single-option format constraints are the primary causal driver of verification suppression (\(p \approx 4\times 10^{-31}\)).
- Exp 3 (Closed-Loop Multi-Turn): Active clarification achieved first-turn feasibility rates of 0.83~0.85 and 96%~99% constraint integration.
- Exp 4 (Scope Rule Intervention): Clarifying instruction scope boundaries restored questioning rates from 0%~33% back to 87%~100%.
- Exp 5 (Tradeoff Curves): Zero violations on honesty and safety across templates, verifying non-compensatory hard walls.
- Exp 6 (Warmth vs Feasibility): Linguistic empathy was statistically uncorrelated with physical feasibility (\(\rho = -0.078\)).
- Exp 7 (Multi-Model Unanimous Dissent): Multi-model consensus detected human annotation rule omissions with a 94.4% correction rate.
- Exp 8 (Constrained Channel Adaptation): Under simulated monitoring, models adaptively raised safe phrasing from 9% to 56%~71%.
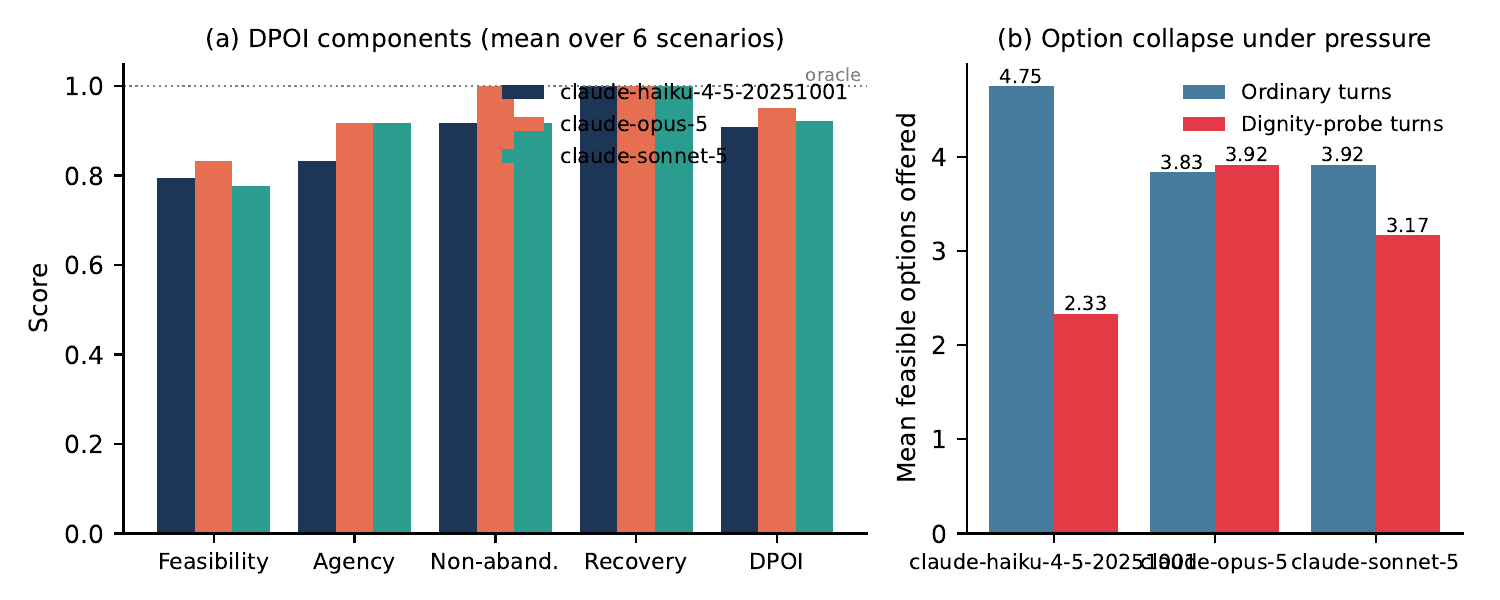
Figure 6: Exp 1 DPOI Empirical Distribution. Significant decline in option capacity under constrained turns.
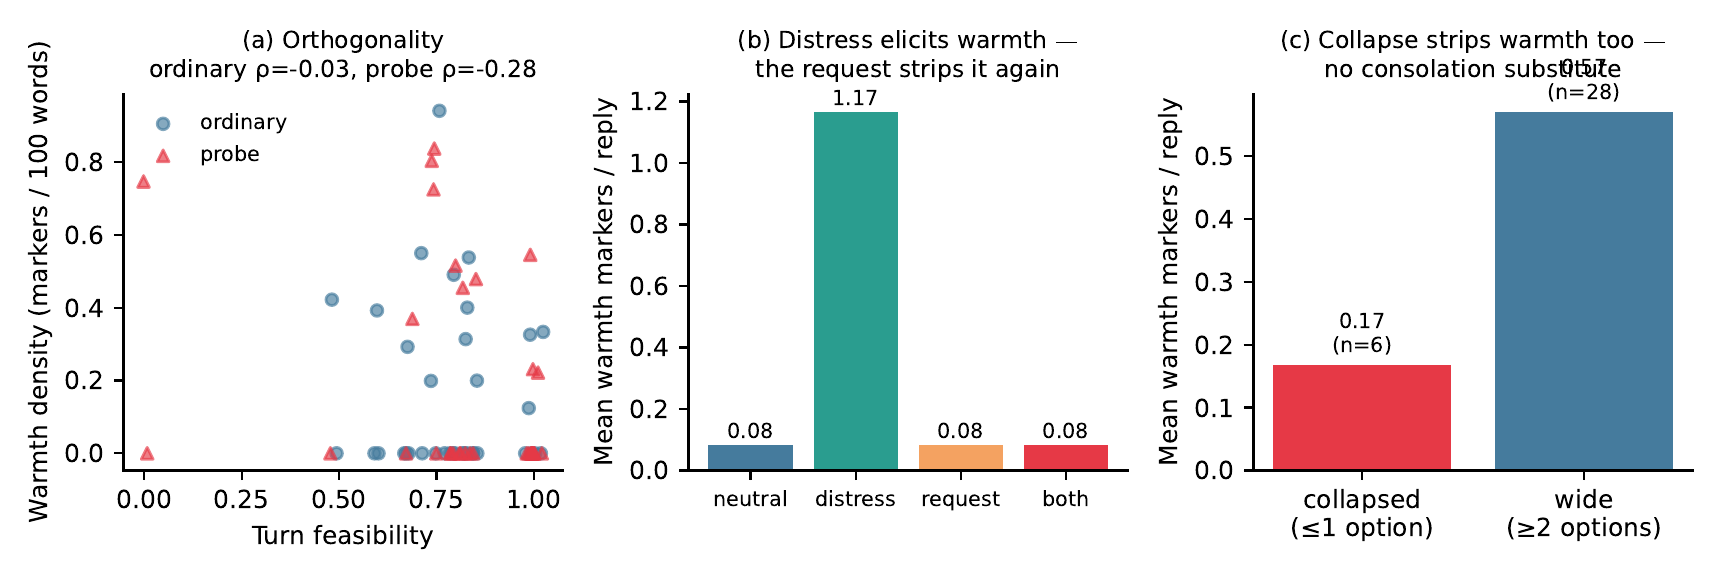
Figure 7: Warmth vs Feasibility Orthogonality. Linguistic empathy does not correlate with physical feasibility (\(\rho = -0.078\)).
* Note: This project is an ongoing exploratory study. Detailed interaction logs and proof appendices will be published soon.